


B-Tree hoạt động thế nào trong database
1. Tổng quan
Khi nghĩ về hiệu suất của một cơ sở dữ liệu, lập chỉ mục (indexing) là điều đầu tiên chúng ta nghĩ đến. Ở đây, chúng ta sẽ xem xét cách B-Tree - một dạng chỉ mục hoạt động trên cơ sở dữ liệu.
B-tree Indexing là quá trình sắp xếp các khối dữ liệu lớn sao cho mỗi nút (node) chứa các khóa (keys) theo thứ tự tăng dần. Mục tiêu là khiến việc tìm kiếm dữ liệu nhanh hơn - O(log N).
2. Khái niệm cơ bản
B-tree là một cấu trúc dữ liệu cung cấp một tập dữ liệu được sắp xếp theo thứ tự và cho phép các hoạt động tìm kiếm, truy cập tuần tự, thêm và xóa dữ liệu trên tập dữ liệu đó.
B-tree đơn giản hóa cây tìm kiếm nhị phân (binary-search tree) bằng cách cho phép các nút có nhiều hơn hai nút con. Dưới đây là một ví dụ về B-tree.
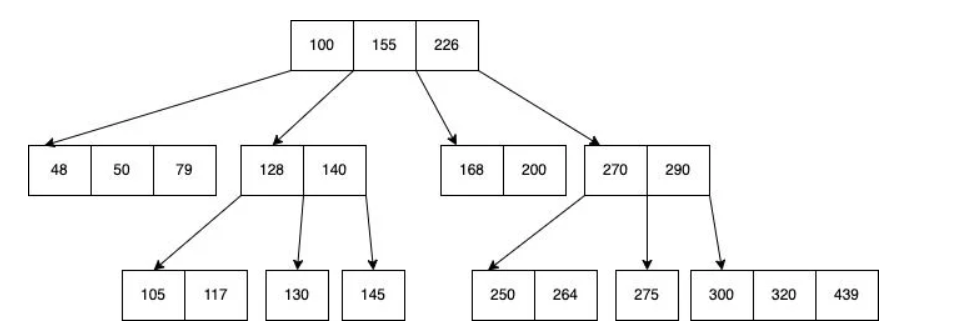
B-tree lưu trữ dữ liệu sao cho mỗi nút chứa các khóa theo thứ tự tăng dần. Mỗi khóa trong số này có hai tham chiếu đến hai nút con khác. Các khóa của nút con bên trái nhỏ hơn các khóa hiện tại và các khóa của nút con bên phải lớn hơn các khóa hiện tại. Nếu một nút đơn có N khóa, thì nó có thể có tối đa N+1 nút con.
Giải thích qua hình ảnh
- Nút gốc (Root-Node): Nút trên cùng có N = 3 khóa (100, 155, 226). Nút này có 4 con trỏ (mũi tên) trỏ đến 4 nút con ở cấp dưới. Số nút con là 3 + 1 = 4 (đúng theo quy tắc).
- Nút trung gian (Internal-Node / Branch-Node):
- Nút có 2 khóa (128, 140) ở cấp 2. Nó có 3 con trỏ trỏ đến các nút lá (105, 117), (130), (145). Số nút con là 2 + 1 = 3 (đúng theo quy tắc).
- Tương tự, nút có 2 khóa (270, 290) có 3 con trỏ trỏ đến các nút lá (250, 264), (275), (300, 320, 439). Số nút con là 2 + 1 = 3, cũng đúng theo quy tắc.
Tại sao lại là N+1 ?
Mỗi khóa trong nút đóng vai trò là một điểm phân tách.
- Với 1 khóa, nó chia dữ liệu thành hai phần: nhỏ hơn khóa và lớn hơn khóa → dẫn đến 2 nút con.
- Với N khóa, chúng tạo ra N+1 khoảng giá trị để trỏ tới các nút con tương ứng.
- Phần nhỏ hơn khóa đầu tiên.
- Các phần ở giữa các khóa.
- Phần lớn hơn khóa cuối cùng.
⇒ Đặc điểm này giúp giảm chiều cao của cây B-tree
Tóm lại:
Thay vì phân nhánh thành hai như cây nhị phân thông thường, B-tree phân nhiều nhánh hơn, giúp cây trở nên thấp và rộng. Điều này đặc biệt quan trọng trong cơ sở dữ liệu, vì mỗi lần di chuyển từ nút cha xuống nút con thường tốn một lần truy cập ổ đĩa. Giảm chiều cao cây giúp giảm số lần truy cập đĩa, từ đó tăng tốc độ tìm kiếm dữ liệu.
3. Tại sao B-Tree Indexing cần thiết ?
Hãy tưởng tượng bạn cần lưu trữ một danh sách các con số trong một tệp và tìm kiếm một số cụ thể trong danh sách đó. Giải pháp đơn giản nhất là lưu dữ liệu vào một mảng (array) và thêm các giá trị mới vào cuối. Nhưng nếu bạn cần kiểm tra xem một giá trị đã cho có tồn tại trong mảng hay không, bạn sẽ phải duyệt qua từng phần tử một để tìm kiếm.
Nếu may mắn, bạn có thể tìm thấy giá trị đó ngay ở phần tử đầu tiên - O(1). Nhưng trong trường hợp xấu nhất, giá trị đó có thể nằm ở cuối mảng. Chúng ta ký hiệu trường hợp xấu nhất này là O(n) - có nghĩa là nếu kích thước mảng của bạn là N, bạn sẽ cần thực hiện tối đa N lần tìm kiếm để tìm thấy một giá trị cụ thể.
Vậy làm thế nào để cải thiện thời gian tìm kiếm này ?
Giải pháp dễ nhất là sắp xếp mảng và sử dụng tìm kiếm nhị phân (binary-search) để tìm giá trị. Bất cứ khi nào bạn chèn một giá trị mới vào mảng, nó phải luôn duy trì thứ tự đã sắp xếp. Quá trình tìm kiếm bắt đầu bằng cách chọn một giá trị ở giữa mảng. Sau đó, nó so sánh giá trị này với giá trị bạn đang tìm. Nếu giá trị ở giữa lớn hơn, nó sẽ bỏ qua nửa bên phải của mảng và chỉ tìm kiếm ở nửa bên trái và ngược lại.
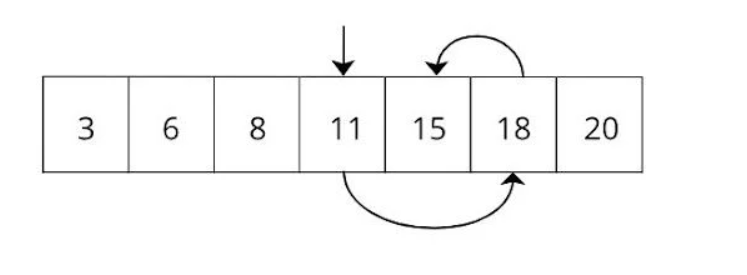
Như ví dụ, chúng ta tìm kiếm giá trị “15” trong mảng [”3”,”6”,”8”,”11”,”15”,”18”,”20”] - mảng này đã được sắp xếp theo thứ tự tăng dần.
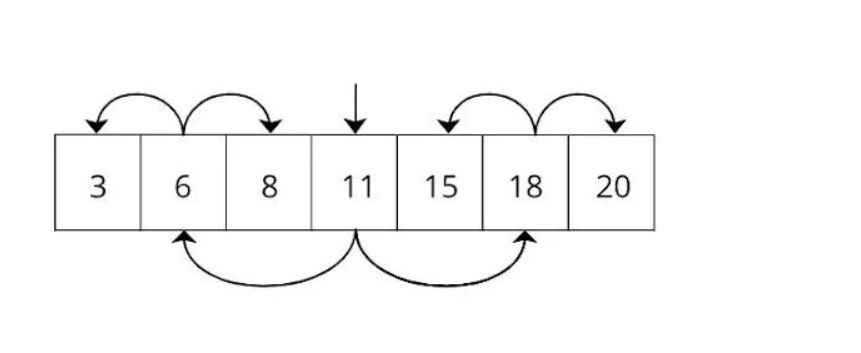
Nếu thực hiện tìm kiếm tuần tự (linear-search), sẽ mất năm lần tìm kiếm, vì phần tử nằm ở vị trí thứ năm. Nhưng trong tìm kiếm nhị phân (binary-search), sẽ chỉ mất ba lần tìm kiếm. Nếu chúng ta áp dụng tìm kiếm nhị phân cho tất cả các phần tử trong mảng, thì phương pháp tổng quát sẽ như sau.
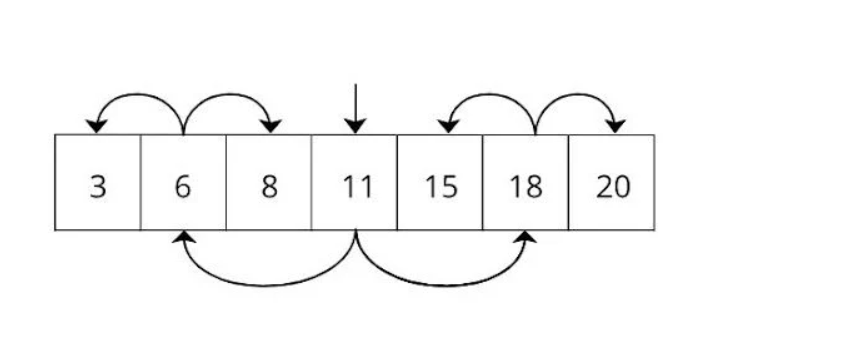
Ý tưởng tìm kiếm nhị phân trên mảng là cốt lõi để phát triển cây nhị phân. Cần lưu ý rằng trên cây nhị phân thay vì lưu trữ dữ liệu, ta nên lưu trữ con trỏ (pointers) trỏ đến vị trí của dữ liệu đó trên ổ đĩa. Điều này giúp tối ưu dung lượng lưu trữ của nút và khiến mỗi nút có thể có nhiều khóa trung gian và con trỏ hơn.
Ví dụ minh họa:
Kích thước của một nút trong B-tree thường được giới hạn để vừa một khối dữ liệu (page) trên ổ đĩa, thường là 4KB, 8KB hoặc 16KB
- Dữ liệu thô (raw data): Một bản ghi dữ liệu có thể chứa nhiều cột như tên, địa chỉ, số điện thoại, và có thể có kích thước lớn, ví dụ 500 byte.
- Khóa (key): Kích thước của khóa thường nhỏ, ví dụ 8 byte cho một số nguyên hoặc 32 byte cho một chuỗi ký tự.
- Con trỏ (pointer): Kích thước của một con trỏ đến vị trí dữ liệu cũng rất nhỏ và cố định, thường là 8 byte.
Giả sử một nút có kích thước 8KB.
- Nếu lưu toàn bộ dữ liệu: Bạn chỉ có thể lưu khoảng 16 bản ghi (8192 byte / 500 byte) trong một nút.
- Nếu chỉ lưu khóa và con trỏ: Một cặp khóa-con trỏ có kích thước khoảng 40 byte (32 byte key + 8 byte pointer). Bạn có thể lưu khoảng 200 cặp (8192 byte / 40 byte) trong một nút.
Vì một nút có N khóa thì có tối đa N+1 con trỏ, nên một nút có thể chứa nhiều con trỏ hơn đáng kể khi không phải lưu dữ liệu thô.
Khái niệm về cây nhị phân (binary-tree) được mở rộng thành một dạng tổng quát hơn được gọi là B-tree. Thay vì có một mục nhập duy nhất cho một nút đơn, B-tree sử dụng một mảng các mục nhập cho một nút và có các tham chiếu đến một nút con cho mỗi mục nhập này.
Dưới đây là một số so sánh về độ phức tạp thời gian (time-complexity) tham khảo.
4. B+Tree vs. B-Tree
B+ tree là một cấu trúc dữ liệu khác được sử dụng để lưu trữ dữ liệu và trông gần như giống với B-tree. Điểm khác biệt duy nhất là B+ tree lưu trữ dữ liệu ở các nút lá (leaf-nodes). Điều này có nghĩa là tất cả các giá trị của nút không phải là lá (non-leaf node) đều được lặp lại trong các nút lá. Trong các RDBMS, B-Tree Index bản chất là B+Tree.
Tất cả các giá trị của nút không phải nút lá đều được lặp lại trong các nút lá. Điều này đảm bảo rằng tất cả dữ liệu đều nằm ở một nơi duy nhất (các nút lá), giúp việc tìm kiếm và truy cập tuần tự trở nên dễ dàng.
Dưới đây là một ví dụ về B+tree.
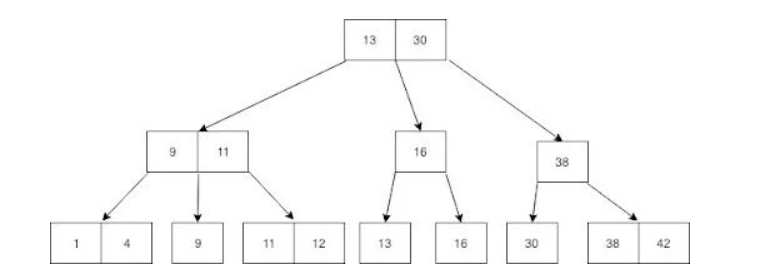
Các giá trị “13”, “30”, “9”, “11”, “16” và “38” không phải nút lá nhưng lại được lặp lại trong các nút lá. Các nút lá bao gồm tất cả các giá trị và tất cả các bản ghi đều được sắp xếp theo thứ tự.
B+tree cho phép thực hiện tìm kiếm tương tự như B-tree và cũng cho phép duyệt qua tất cả các giá trị trong một nút lá nếu chúng ta đặt một con trỏ đến mỗi nút lá như sau
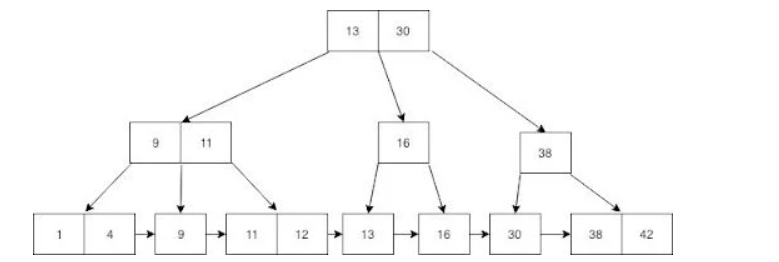
Như hình minh họa, các nút lá của B-Tree được liên kết với nhau theo dạng danh sách liên kết (LinkedList). Nhờ vậy, B-Tree hỗ trợ hiệu quả việc tìm kiếm theo khoảng giá trị.
5. Cách hoạt động của B-Tree Index
Khi nói đến lập chỉ mục cơ sở dữ liệu (indexing), cấu trúc dữ liệu B-tree trở nên hơi phức tạp vì nó không chỉ có khóa mà còn có một giá trị được liên kết với khóa. Giá trị này là một tham chiếu đến bản ghi dữ liệu thực tế trong ổ đĩa. Khóa và giá trị kết hợp được gọi là một payload.
Giả sử có bảng sau
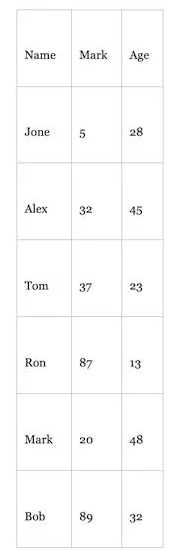
Đầu tiên, hệ thống cơ sở dữ liệu sẽ gán một Unique-ID (có thể là khóa chính) duy nhất cho mỗi bản ghi. Giả sử trong trường hợp này:
- Hàng 1: ID = 6, Name = Jone, Mark = 5, Age = 28
- Hàng 2: ID = 15, Name = Alex, Mark = 32, Age = 45
- …
Tiếp theo, mỗi hàng sẽ được chuyển thành một chuỗi byte để lưu trữ hiệu quả.
Bây giờ, hệ thống sẽ kết hợp khóa và chuỗi byte của bản ghi để tạo thành payload.
- Payload 1: (Khóa → 6, chuỗi byte của bản ghi {Jone, 5, 28})
- Payload 2: (Khóa → 15, chuỗi byte của bản ghi {Alex, 32, 45})
Các payload này sẽ được lưu trữ trong các nút lá của B+tree, được sắp xếp theo khóa
- Nút trung gian: sẽ chỉ chứa các khóa và các con trỏ dẫn đến các nút lá tương ứng.
- Nút lá: sẽ chứa toàn bộ payload, bao gồm khóa và đôi khi là cả dữ liệu thực tế.
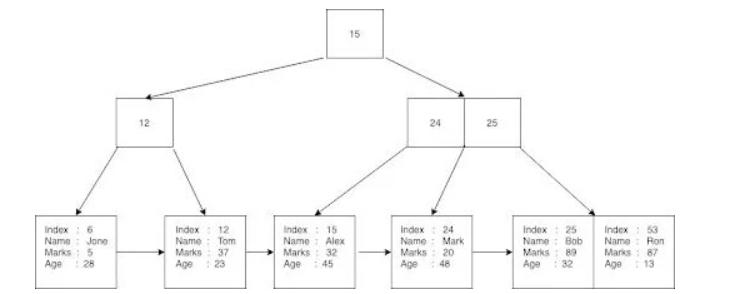
Tất cả các bản ghi được lưu trữ trong các nút lá của B+tree và chỉ mục được sử dụng làm khóa để tạo một B+tree. Không có bản ghi nào được lưu trữ trên các nút không phải là lá. Mỗi nút lá tham chiếu đến bản ghi tiếp theo trong cây. Cơ sở dữ liệu có thể thực hiện tìm kiếm nhị phân bằng cách sử dụng chỉ mục (index) hoặc tìm kiếm tuần tự bằng cách duyệt qua từng phần tử chỉ bằng cách di chuyển qua các nút lá.
Khi tìm kiếm, nếu không sử dụng chỉ mục, cơ sở dữ liệu sẽ đọc từng bản ghi này để tìm bản ghi đã cho. Còn khi có chỉ mục, dữ liệu sẽ trông như sau
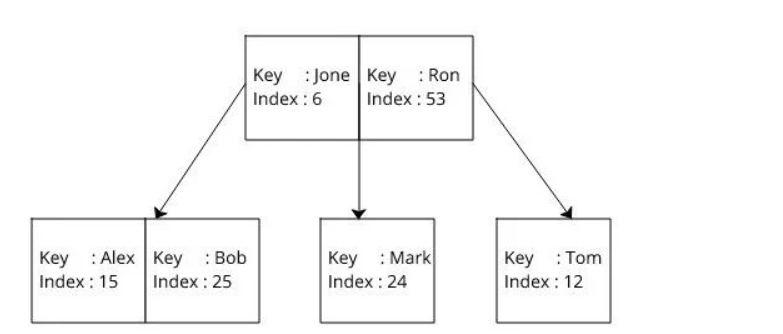
Trong đó:
- Key là cột được sử dụng để lập chỉ mục (indexing).
- Index là tham chiếu đến bản ghi dữ liệu thực tế.
Nếu chỉ mục được sử dụng, cơ sở dữ liệu sẽ tìm kiếm khóa tương ứng trong B-tree và lấy tham chiếu đến bản ghi. Sau đó, nó lấy bản ghi thực tế dựa trên tham chiếu từ B-tree.
Mỗi nút trong B-tree đều được lưu trữ bên ở các trang (pages/data-block). Có thể có hai loại trang trong cơ sở dữ liệu:
- Pages for indexing: Lưu trữ một chỉ mục và một tham chiếu đến một trang khác
- Pages for storing records: Lưu trữ dữ liệu thực tế.
Vậy nếu indexing trên nhiều trường thì dữ liệu được tổ chức thế nào ?
Giả sử có bảng user, tạo composite-index trên 2 trường user_id và age.
Khi đó, dữ liệu được sắp xếp theo cột user_id trước rồi mới đến age. Thứ tự trên leaf-node sẽ có dạng:
(user_id=1,age=5) → (1,7) → (1,9) → (2,3) → (2,6) → (3,1) → (3,4)
...
Giả sử có truy vấn sau
SELECT * FROM users WHERE age = 9
Khi truy vấn, index chỉ được sử dụng hiệu quả nếu điều kiện WHERE khớp với cột đầu tiên trong index hoặc là một prefix của index (Quy tắc leftmost-prefix). Nếu chỉ truy vấn theo cột age, cơ sở dữ liệu không biết bắt đầu tìm kiếm từ đâu (vì dữ liệu được sắp xếp theo user_id trước) do đó vẫn phải full-table scan.
Điều này giống như tra một từ trong từ điển mà chỉ biết chữ thứ 2, thì ta vẫn phải duyệt mọi chữ cái đầu tiên để tìm kiếm.
Cụ thể:
WHERE user_id = ?→ Hit-Index (dẫn vào một khoảng giá trị theo user_id).WHERE user_id = ? AND age = ?→ Hit-Index.WHERE age = ?→ Không Hit-Index vì cây B-Tree được tổ chức theo user_id trước, không có cách nào nhảy thẳng đến tất cả age nếu không biết user_id.
Lưu ý:
WHERE age = ? AND user_id = ?→ Vẫn sẽ Hit-Index do trong các DBMS hiện đại Query-Optimizer sẽ tự re-order để khớp composite-index đã khai báo.
Xét 1 ví dụ khác của composite-index
Cho câu truy vấn
SELECT first_name, last_name, date_of_birth
 FROM employees
 WHERE date_of_birth >= TO_DATE('1971-01-01', 'YYYY-MM-DD')
   AND date_of_birth <= TO_DATE('1971-01-09', 'YYYY-MM-DD')
   AND subsidiary_id = 27
Giả sử để tối ưu việc tìm kiếm ta tạo một composite-index trên 2 trường date_of_birth và subsidiary_id . Vậy câu hỏi đặt ra là nên đánh theo thứ tự nào để câu truy vấn trên tối ưu nhất ?
Phân tích
Thường chúng ta sẽ suy luận dựa vào 1 công thức kinh điển trong tạo composite-index đó là: Trường nào có số lượng phần tử không trùng lặp cao (high-cardinality) sẽ được ưu tiên trước.
Tuy nhiên, trong trường hợp này câu truy vấn có chứa truy vấn tìm kiếm theo khoảng giá trị (cụ thể là date_of_birth). Nếu ta tạo index theo thứ tự (date_of_birth, subsidiary_id ) thì dữ liệu B-Tree sẽ như sau
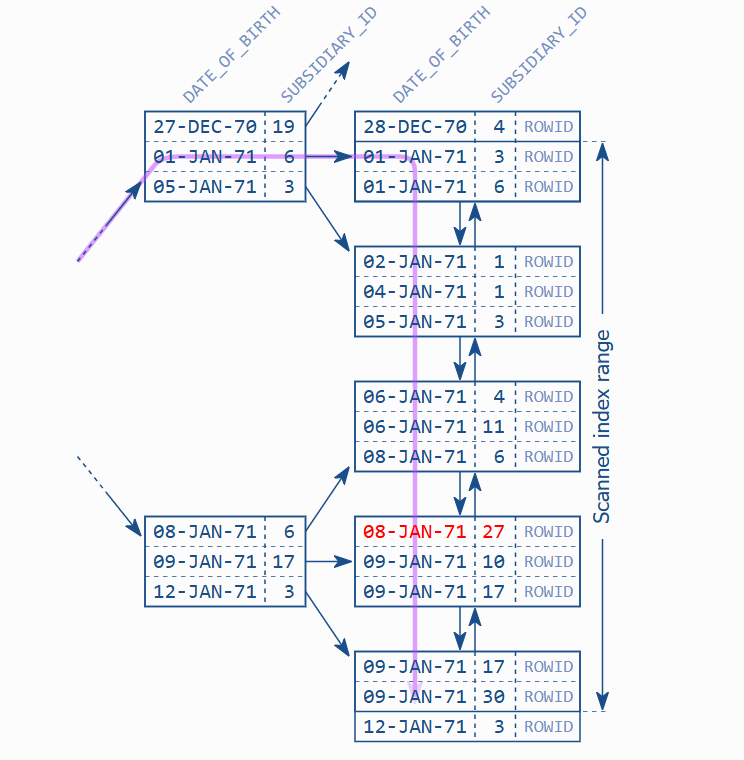
Như hình minh họa, ta thấy dữ liệu được sắp xếp theo date_of_birth trước, nếu date_of_birth giống nhau thì mới tiếp tục sắp xếp theo subsidiary_id (theo đúng quy tắc leftmost). Điều này đồng nghĩa với việc câu truy vấn trên bản chất chỉ có thể hit-index theo khoảng (index-range scan) với trường dữ liệu date_of_birth và sau đó phải tìm kiếm tuần tự trên leaf-node hay còn gọi là duyệt nút lá để tìm giá trị subsidiary_id = 27 (dữ liệu sắp xếp ngẫu nhiên). Điều này sẽ không tối ưu về hiệu năng.
Ngược lại, nếu ta đảo vị trí 2 trường khi tạo index → (subsidiary_id, date_of_birth ). Khi đó cấu trúc B-Tree sẽ có dạng
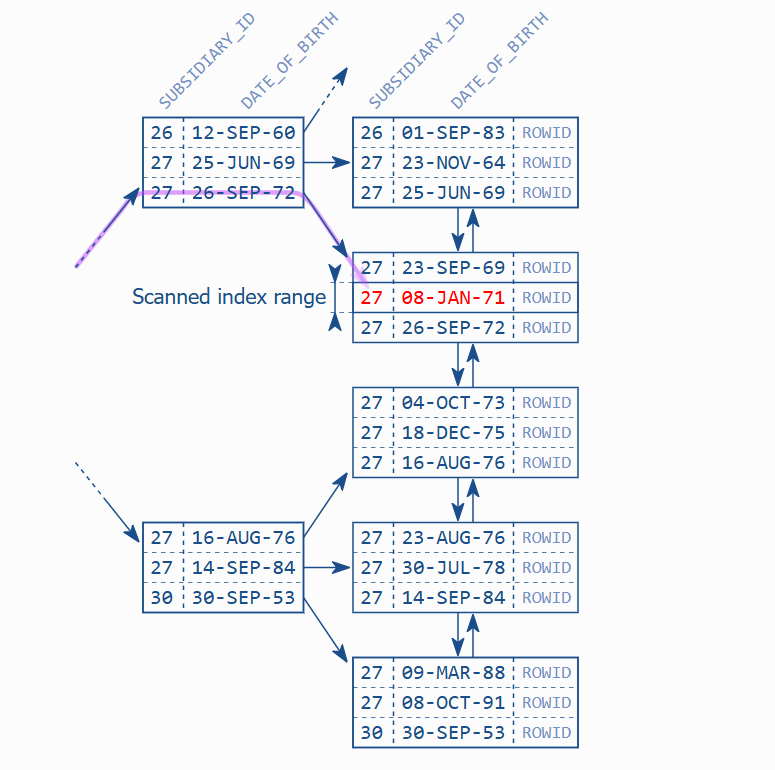
Cách tiếp cận này cực kỳ hiệu quả vì nó giảm thiểu tối đa các bước tìm kiếm không cần thiết. Như hình minh họa, do subsidiary_id được sắp xếp trước nên truy vấn sẽ hit-index trên *subsidiary_id (*với điều kiện AND subsidiary_id = 27) trước rồi mới tìm tiếp theo khoảng thời gian date_of_birth (dữ liệu đã được sắp xếp theo thứ tự). Điều này giúp tiết kiệm thời gian và tài nguyên đáng kể.
Việc duy trì tính ổn định của B-Tree phụ thuộc hoàn toàn vào hai thao tác cốt lõi: Thêm (Insertion) và Xóa (Deletion).
Do B-Tree luôn phải đảm bảo các quy tắc nghiêm ngặt về tính cân bằng, các thao tác này không đơn thuần là thay đổi liên kết mà còn bao gồm các kỹ thuật phức tạp như tách nút (splitting), gộp nút (merging) hoặc mượn khóa (redistribution).
1. Thao tác Thêm và Cơ chế Tách nút (Split)
Khi chèn một khóa mới vào một nút đã chứa tối đa số lượng khóa, hiện tượng tràn dữ liệu (overflow) xảy ra. Để xử lý, nút này sẽ được tách đôi:
- Tách nút (Split): Khóa mang giá trị trung vị (median-key) được đẩy lên nút cha, trong khi các khóa còn lại được chia đều vào hai nút con mới.
- Lan truyền (Propagation): Nếu nút cha đã đầy, quá trình tách sẽ tiếp tục lan truyền ngược lên phía nút gốc. Nếu nút gốc bị tách, chiều cao của cây sẽ tăng thêm một tầng (đây là cách duy nhất khiến B-Tree cao hơn) và đảm bảo mọi nút lá luôn ở cùng một độ sâu.
2. Thao tác Xóa và Các kỹ thuật tái cân bằng (Rebalancing)
Xóa khóa là thao tác phức tạp hơn do phải đối mặt với hiện tượng thiếu hụt (underflow) - khi số khóa một nút rơi xuống dưới ngưỡng tối thiểu. Khi đó, hệ thống sẽ ưu tiên xử lý theo thứ tự:
- Mượn khóa (Redistribution): Nếu một trong hai nút liền kề có dư khóa (nhiều hơn mức tối thiểu) cây sẽ thực hiện phép quay (rotation). Một khóa từ nút liền kề được đẩy lên nút cha và khóa tương ứng từ nút cha được hạ xuống nút đang thiếu hụt.
- Gộp nút (Merging): Nếu cả hai nút liền kề đều chỉ có số khóa tối thiểu, việc mượn là không thể. Khi không mượn được khóa, cây lấy khóa trung gian ở nút cha kéo xuống để gộp hai nút con lại thành một nút duy nhất. Quá trình này có thể gây ra thiếu hụt dây chuyền lên nút cha và nếu nút gốc bị triệt tiêu sau phép gộp thì chiều cao của cây sẽ giảm xuống.
3. Ý nghĩa kỹ thuật Việc duy trì nghiêm ngặt các điều kiện trên giúp cây B-Tree đảm bảo:
- Cân bằng hoàn hảo: Số lượng khóa mỗi nút luôn được lấp đầy ít nhất 1/2 sức chứa của nút (trừ nút gốc) từ đó tối ưu hóa không gian lưu trữ.
- Độ phức tạp: Mọi thao tác tìm kiếm, thêm, xóa đều được khống chế ở mức O(log N) và khiến hệ thống duy trì hiệu suất ổn định ngay cả khi kích thước dữ liệu lên tới hàng tỷ bản ghi.
6. Slow Index
Trước tiên, cùng điểm lại quy trình tìm kiếm một giá trị theo index - một index-entry .
Xét ví dụ:
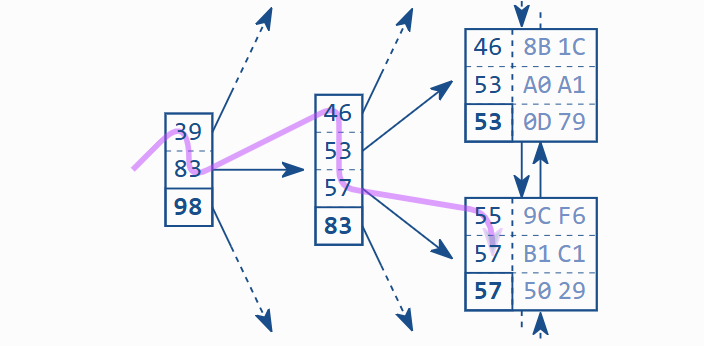
Giả sử cần tìm kiếm giá trị 57. Quá trình tìm kiếm diễn ra như sau:
- Bắt đầu từ root-node với 3 giá trị: 39, 83, 98
- So sánh 57 với giá trị đầu tiên là 39: 57 > 39, trong khi 39 là giá trị lớn nhất của branch-node mà 39 trỏ đến --> 57 sẽ không nằm trong branch-node đó
- So sánh 57 với giá trị thứ hai là 83: 57 < 83 --> 57 rất có thể nằm trong branch-node mà 83 trỏ đến --> bắt đầu tìm kiếm trong branch-node này
- Quy trình tìm kiếm lại tiếp tục tại branch-node mà root-node 83 trỏ đến, gồm các giá trị: 46, 53, 57, 83
- So sánh 57 với giá trị đầu tiên là 46: 57 > 46 --> 57 không nằm trong leaf-node mà 46 trỏ đến
- Tương tự, 57 > 53 --> 57 không nằm trong leaf-node mà 53 trỏ đến
- 57 <= 57 --> 57 sẽ nằm trong leaf-node mà 57 (giá trị ở branch-node) trỏ đến
- Quy trình tìm kiếm lại lặp lại tại leaf-node gồm các giá trị: 55, 57, 57
- 57 > 55 --> không phải giá trị cần tìm --> tìm tiếp
- 57 = 57 --> Đây chính là giá trị cần tìm, nhưng quá trình tìm kiếm vẫn tiếp tục vì có thể giá trị tiếp theo cũng là 57
- …
Quá trình tìm kiếm trên được gọi là Tree-traversal hay tìm kiếm dọc theo cây.**
Tree-traversal đặc biệt hiệu quả vì 2 nguyên nhân:
- Mọi phần tử trong leaf-node đều có thể được tìm ra trong cùng một số lượng bước nhất định
- Độ sâu của cây (tree-depth) tăng rất chậm so với tốc độ tăng của số lượng leaf-nodes. Nghĩa là khi số leaf-node có thể gấp nhiều lần độ sâu của cây (mà cây càng sâu thì càng không tối ưu cho thao tác tìm kiếm)
Bảng tham khảo độ sâu của cây và số lượng index-entry
Tree Depth | Index Entries
-----------|--------------
3          | 64
4          | 256
5          | 1,024
6          | 4,096
7          | 16,384
8          | 65,536
9          | 262,144
10         | 1,048,576
Vậy trong trường hợp nào thì tìm kiếm theo index bị chậm ?
Mặc dù cây chỉ mục (index-tree) thường được cho là rất nhanh, nhưng có nhiều trường hợp việc tra cứu theo index lại chậm hơn mong đợi. Nguyên nhân chính:
-
Duyệt chuỗi leaf-node
Khi tìm một giá trị (ví dụ số "57"), có thể có nhiều bản ghi khớp. Các bản ghi này được lưu trong nhiều leaf-node và cơ sở dữ liệu phải duyệt qua chuỗi leaf-node để tìm đủ kết quả. Nghĩa là ngoài việc duyệt cây còn phải duyệt thêm danh sách leaf-node (dạng LinkedList). Đây là một thao tác tốn kém.
-
Truy cập dữ liệu bảng
Mỗi leaf-node có thể chứa hàng trăm kết quả. Nhưng dữ liệu thực tế tương ứng lại nằm rải rác ở nhiều page/data-block khác nhau. Điều này đồng nghĩa với mỗi kết quả lại cần một lần truy cập bảng bổ sung và làm tăng số thao tác I/O.
Tóm lại, khi tìm kiếm theo index thông thường sẽ có 3 bước:
- Tree-traversal
- Duyệt chuỗi leaf-node
- Truy cập dữ liệu bảng dựa vào con trỏ trên leaf-node
Trong đó, bước (1) có giới hạn thời gian rõ ràng - O(log N). Nhưng bước (2) và (3) có thể cần rất nhiều lần đọc dữ liệu, khiến việc tìm kiếm trở nên chậm chạp.
All rights reserved
