


AWS EMR (Cập nhật 2026)
1. EMR là gì?
Theo tài liệu chính thức, Amazon EMR là một dịch vụ web giúp xử lý lượng dữ liệu khổng lồ một cách hiệu quả, sử dụng Apache Hadoop kết hợp với các dịch vụ của AWS.
2. Định nghĩa là thế nhưng nó giúp được gì?
Ví dụ bạn là một data engineer cho một trang thương mại điện tử.
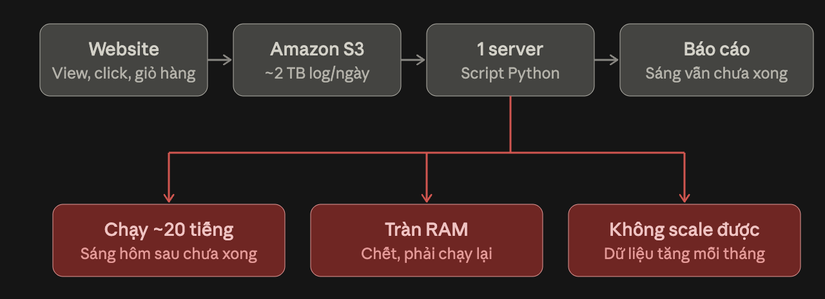
Mỗi ngày website sinh ra khoảng 2 TB log (lượt xem sản phẩm, click, thêm vào giỏ, thanh toán…) và tất cả được đổ vào Amazon S3.
Hiện tại bạn chạy một script Python trên 1 server để đọc log và tổng hợp báo cáo. Nhưng cuối cùng kết quả là:
- Script chạy gần 20 tiếng, sáng hôm sau vẫn chưa xong.
- Thỉnh thoảng bị tràn RAM và chết giữa chừng, phải chạy lại từ đầu.
- Dữ liệu tăng mỗi tháng, mua server to hơn thì đắt mà sớm muộn cũng không đủ.
Lúc này nếu có ông Thần Đèn thì bạn chỉ mong có 3 điều ước thế này thôi:
- Báo cáo có sẵn trước 7h sáng.
- Thời gian xử lý giảm từ ~20 tiếng xuống còn dưới 1 tiếng.
- Chi phí chỉ phát sinh khi thật sự chạy, không nuôi server cả ngày.
Ông Thần Đèn có role Tech lech hiện lên và nói:
Thay vì 1 máy làm 2 TB, sao mi không chia nhỏ dữ liệu cho 20 máy, mỗi máy làm khoảng 100 GB cùng lúc, rồi gộp kết quả lại.
Ở server Trái Đất này, các framework mã nguồn mở sau đây sinh ra để làm việc đó rồi nè:
| Framework | Vai trò | Áp dụng vào ví dụ |
|---|---|---|
| Apache Hadoop | Ông tổ của xử lý phân tán. Gồm HDFS (lưu trữ dữ liệu trên nhiều máy) và MapReduce (chia việc ra nhiều máy rồi gộp kết quả). Xử lý theo lô (batch), đọc/ghi qua ổ đĩa nên khá chậm. | Có thể dùng để tổng hợp log hằng đêm, nhưng không phải lựa chọn nhanh nhất. |
| Apache Spark | Thế hệ sau của Hadoop MapReduce, xử lý chủ yếu trên RAM nên nhanh hơn nhiều. Hỗ trợ batch, SQL và machine learning. | ⭐ Dùng để chạy job tổng hợp 2 TB log mỗi đêm. |
| Trino | Công cụ truy vấn SQL tương tác trên dữ liệu lớn, trả kết quả trong vài giây đến vài phút. | ⭐ Cho team Marketing tự viết SQL tra cứu dữ liệu trên S3. |
| Apache Flink | Xử lý dữ liệu dạng luồng (streaming) theo thời gian thực, từng sự kiện ngay khi nó đến. | ⭐ Phát hiện giao dịch đáng ngờ ngay lập tức. |
Sau khi nghe Thần Đèn nói, bạn oà lên như muốn khóc.
Như vậy về mặt công nghệ, bạn chỉ cần biết Spark, Trino và Flink là mọi thứ sẽ được giải quyết.
Thần Đèn lại cười khẩy rồi nói:
Mi định tự dựng các công cụ này thế nào?
Bạn gần như chết lặng như chiếc xe máy chết máy sau một trận mưa to ở Sài Gòn.
Muốn chạy Spark trên 20 máy, bạn buộc phải tự làm hết:
- Thuê hoặc mua 20 server, cấu hình mạng giữa chúng.
- Cài Java, Hadoop, Spark, Trino, Flink và đảm bảo các phiên bản tương thích với nhau (đây là phần rất mất thời gian).
- Cấu hình master node, worker node, tuning bộ nhớ.
- Viết cơ chế cho phép Spark đọc dữ liệu từ S3.
- Theo dõi khi một máy chết, thay máy, cập nhật bản vá bảo mật.
- 20 máy chạy 24/7 trong khi job chỉ chạy 1 tiếng mỗi đêm, nên lãng phí 23 tiếng tiền server.
Kết quả là bạn mất vài tuần chỉ để dựng hạ tầng, chưa viết được dòng code xử lý dữ liệu nào.
Tự nhiên có một ông Bụt với role expert AWS với 20 năm kinh nghiệm hiện lên và nói:
Con đừng lo, để giải quyết việc con muốn đã có Amazon EMR rồi
EMR đóng vai trò người dựng và vận hành hạ tầng thay bạn.
Bạn chỉ cần tập trung viết code Spark/SQL thôi.
Ưu điểm khi bạn dùng AWS EMR:
| # | Tiện ích | EMR làm gì cho bạn | Áp dụng trong ví dụ |
|---|---|---|---|
| ① | Tạo cluster trong vài phút | Tự cài đặt, cấu hình và đảm bảo các phiên bản phần mềm tương thích với nhau | Trên AWS Console, chọn "Spark + Trino", chọn số lượng và loại máy, rồi bấm Create |
| ② | Đọc dữ liệu trực tiếp từ S3 | Thông qua EMRFS, EMR dùng Amazon S3 làm nơi lưu trữ cho Hadoop | Không cần copy 2 TB sang chỗ khác, code Spark chỉ cần trỏ vào s3://... |
| ③ | Tự động tăng/giảm số máy | Tự điều chỉnh số node theo khối lượng công việc | Flash Sale, log tăng gấp 3 lần thì EMR tự thêm máy. Ngày thường thì giảm lại |
| ④ | Chỉ trả tiền khi chạy | Bật cluster khi cần, tự tắt khi xong. Hoặc dùng EMR Serverless: chỉ submit job, AWS lo phần còn lại | Lên lịch mỗi đêm lúc 2h: bật cluster → chạy job Spark → ghi kết quả ra S3 → tự tắt cluster |
| ⑤ | Mở rộng dễ dàng | Thêm framework mới mà không phải dựng lại hạ tầng từ đầu | Trino: team Marketing tự viết SQL trên dữ liệu ở S3 Flink: phát hiện gian lận real-time |
2. Các loại EMR hiện nay
| Loại | Mô tả |
|---|---|
| EMR on EC2 | Cho phép kiểm soát cấu hình cluster và hỗ trợ cluster chạy lâu dài, phù hợp với tác vụ xử lý dữ liệu liên tục cần cấu hình phần cứng cụ thể. |
| EMR on EKS | Chạy workload big data trên AWS, trong khi EMR on EKS tự build, cấu hình và quản lý container cho các ứng dụng mã nguồn mở của bạn. |
| EMR Serverless | Chạy các framework như Apache Spark mà không cần cấu hình, quản lý hay scale cluster hoặc server. |
| EMR on AWS Outposts | Được liệt kê trong tài liệu chính thức như một hình thức triển khai riêng (chạy EMR trên hạ tầng AWS Outposts đặt tại chỗ). |
3. Cách triển khai thực tế
Để triển khai thì khá đơn giản, nó chỉ cần yêu cầu bạn làm 2 điều:
- Tạo 1 EMR Cluster (Cái này chỉ bao gồm việc cấu hình các máy node,... nên bạn dùng cluster này cho job khác vẫn được)
- Tạo 1 job và submit job đó cho Cluster mà bạn đã tạo (Cái này thì tuỳ vào Cluster bạn tạo thì bạn submit job thôi, như mình nói ở trên thì bạn tạo một Cluster chung cho nhiều job khác nhau vẫn oke nhé.)
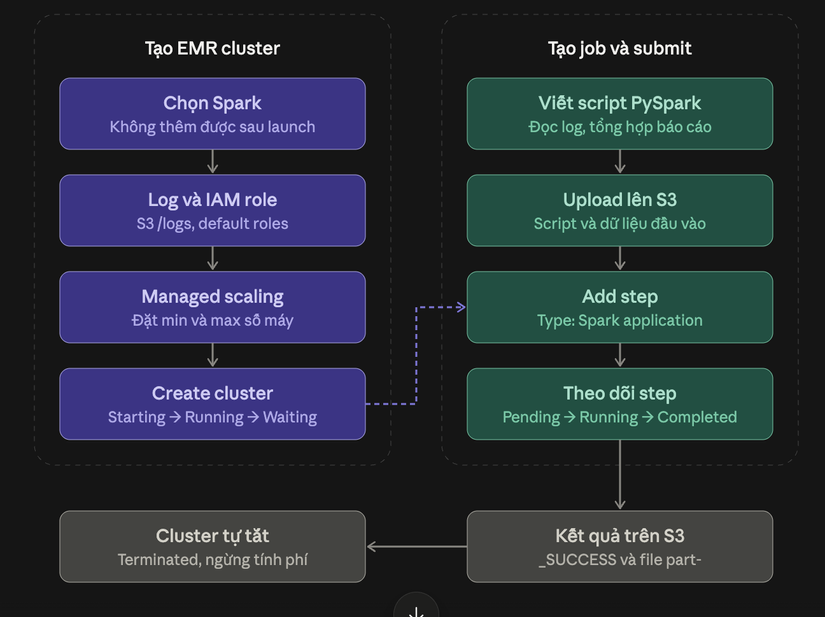
Ví dụ tạo Cluter:
aws emr create-cluster \
--name "Daily Report Cluster" \
--release-label <emr-release> \
--applications Name=Spark \
--ec2-attributes KeyName=<myEMRKeyPairName> \
--instance-type m5.xlarge \
--instance-count 3 \
--use-default-roles
--managed-scaling-policy ComputeLimits='{MinimumCapacityUnits=2,MaximumCapacityUnits=4,UnitType=Instances}'
--auto-terminate
Ví dụ tạo job và submit:
aws emr add-steps \
--cluster-id <myClusterId> \
--steps Type=Spark,Name="Daily report",ActionOnFailure=CONTINUE,Args=[s3://my-ecommerce-logs/scripts/daily_report.py,--data_source,s3://my-ecommerce-logs/raw/2026-10-05/,--output_uri,s3://my-ecommerce-logs/reports/2026-10-05/]
Kiểm tra trạng thái:
aws emr describe-step --cluster-id <myClusterId> --step-id <s-XXXXXXXX>
Trạng thái step chuyển từ PENDING → RUNNING → COMPLETED.
4. Kết hợp EMR với các dịch vụ AWS khác
Trong thực tế, EMR hiếm khi chạy một mình. Nó đóng vai trò là bộ máy xử lý, còn các dịch vụ khác lo phần lưu trữ, quản lý metadata, lập lịch, giám sát và bảo mật.
Tổng quan
| Nhóm | Dịch vụ | Vai trò khi kết hợp với EMR | Áp dụng vào ví dụ log 2 TB |
|---|---|---|---|
| Lưu trữ | Amazon S3 | Nơi chứa dữ liệu đầu vào, script, kết quả và log | Chứa log thô và báo cáo |
| Lưu trữ | Amazon DynamoDB | Đọc/ghi dữ liệu NoSQL trực tiếp từ EMR | (Tùy chọn) Lưu kết quả để ứng dụng tra cứu nhanh |
| Metadata | AWS Glue Data Catalog | Kho metadata chung (bảng, schema, partition) | Đăng ký bảng log, bảng báo cáo |
| Truy vấn | Amazon Athena | Truy vấn SQL các bảng đã có trong Glue Data Catalog | Team Marketing tự viết SQL |
| Điều phối | AWS Step Functions | Tạo cluster → chạy step → tắt cluster theo workflow | Pipeline báo cáo hằng đêm |
| Lập lịch | Amazon EventBridge Scheduler | Kích hoạt workflow theo lịch | Chạy lúc 2h sáng mỗi ngày |
| Giám sát | Amazon CloudWatch | Thu thập metric của cluster, tạo cảnh báo | Cảnh báo khi job lỗi hoặc cluster bị bỏ quên |
| Bảo mật | IAM, VPC, Lake Formation | Phân quyền, cô lập mạng, kiểm soát truy cập dữ liệu | Giới hạn ai được đọc dữ liệu nào |
4.1. Lưu trữ: S3 và DynamoDB
Amazon S3
- EMR có thể dùng nhiều kho dữ liệu khác nhau như Amazon S3, HDFS và Amazon DynamoDB.
- Thông qua EMRFS, EMR dùng S3 làm object store cho Hadoop.
- Vì HDFS sẽ mất khi cluster tắt, kết quả nên được ghi ra S3.
Amazon DynamoDB
- EMR tích hợp trực tiếp với DynamoDB, cho phép xử lý dữ liệu trong DynamoDB và chuyển dữ liệu qua lại giữa DynamoDB, S3 và HDFS.
4.2. Metadata và truy vấn: Glue Data Catalog + Athena
Vấn đề: Spark ghi kết quả ra S3 dưới dạng file. Nhưng team Marketing không biết file nằm ở đâu, có những cột gì. Cần một nơi ghi lại "bảng nào, schema thế nào, nằm ở đâu trên S3".
Giải pháp: AWS Glue Data Catalog
- Từ EMR 5.8.0 trở lên, có thể cấu hình Spark dùng Glue Data Catalog làm Apache Hive metastore.
- Glue Data Catalog là kho metadata thống nhất, tích hợp với EMR, Amazon RDS, Amazon Redshift, Redshift Spectrum, Athena và mọi ứng dụng tương thích Hive metastore.
- Từ EMR 6.5.0 trở lên còn có thể dùng Glue Data Catalog với Apache Iceberg.
Cách bật trên Console: khi tạo cluster, ở mục AWS Glue Data Catalog settings, tick Use for Spark table metadata.
💡 Cách này khác với phương án dùng Trino trên EMR ở mục trước là Athena là dịch vụ riêng, không cần cluster EMR phải đang chạy để Marketing truy vấn.
4.3. Điều phối và lập lịch: Step Functions + EventBridge Scheduler
Phần "chạy lúc 2h sáng mỗi đêm" chưa được giải quyết. Đây là cách AWS hỗ trợ:
AWS Step Functions có tích hợp sẵn với EMR, cung cấp các API như:
| API trong Step Functions | Chức năng |
|---|---|
createCluster / createCluster.sync |
Tạo và khởi động cluster |
addStep / addStep.sync |
Thêm step vào cluster đang chạy. Bản .sync sẽ chờ step chạy xong |
terminateCluster / terminateCluster.sync |
Tắt cluster |
Amazon EventBridge Scheduler có thể khởi chạy state machine của Step Functions theo lịch, ví dụ để tự động hóa một job xử lý dữ liệu.
Lịch được định nghĩa bằng biểu thức cron hoặc rate.
Workflow trong ví dụ:
| # | Thành phần | Hành động |
|---|---|---|
| 1 | EventBridge Scheduler | Đúng 2h sáng, gọi Step Functions StartExecution |
| 2 | Step Functions → createCluster.sync |
Tạo cluster EMR có Spark, chờ đến khi sẵn sàng |
| 3 | Step Functions → addStep.sync |
Submit job daily_report.py, chờ đến khi xong |
| 4 | Step Functions → terminateCluster.sync |
Tắt cluster |
Phương án khác: nếu team đã dùng Apache Airflow, AWS có hướng dẫn kích hoạt EMR step từ Amazon MWAA. Từ Airflow có thể tắt cluster bằng một task cuối, hoặc đặt auto-termination policy theo thời gian nhàn rỗi.
4.4. Giám sát: Amazon CloudWatch
- Metric được cập nhật 5 phút một lần và tự động đẩy lên CloudWatch cho mọi cluster EMR.
- Các metric EMR gửi lên CloudWatch không mất phí, được lưu trữ 63 ngày rồi xóa.
- Có thể xem metric trên tab Monitoring của cluster trong EMR console, hoặc trong CloudWatch console.
- Một metric hữu ích là
IsIdle, cho biết cluster đang chạy task hay đang rảnh.
Áp dụng vào ví dụ:
| Cảnh báo | Mục đích |
|---|---|
Cluster rảnh quá lâu (IsIdle) |
Phát hiện cluster bị bỏ quên, tránh tốn tiền |
| Job lỗi | Biết ngay để chạy lại trước 7h sáng |
📝 AWS khuyến nghị theo dõi kỹ metric CloudWatch vì managed scaling phụ thuộc vào chúng để hoạt động.
4.5. Bảo mật và mạng: IAM, VPC, Lake Formation
| Dịch vụ | Vai trò |
|---|---|
| IAM | Các tiến trình ứng dụng trên EMR dùng EC2 instance profile khi gọi dịch vụ AWS khác. |
| Amazon VPC | Có thể launch cluster trong VPC, một phần mạng được cô lập logic trên AWS |
| AWS Lake Formation | Với EMR Serverless, có thể bật Lake Formation để kiểm soát truy cập dữ liệu theo chính sách bảo mật |
Ngoài ra, với cluster dùng chung cho nhiều người, EMR có các tùy chọn để quản lý quyền truy cập của từng người dùng vào dữ liệu S3.
Kiến trúc tổng thể cho ví dụ
| Luồng | Mô tả |
|---|---|
| ① Thu thập | Website → đổ log vào S3 |
| ② Lập lịch | EventBridge Scheduler lúc 2h → khởi chạy Step Functions |
| ③ Xử lý | Step Functions tạo cluster EMR → chạy job Spark → tắt cluster |
| ④ Metadata | Spark đăng ký bảng kết quả vào Glue Data Catalog |
| ⑤ Sử dụng | Team Marketing truy vấn bằng Athena |
| ⑥ Giám sát | CloudWatch theo dõi cluster và cảnh báo |
| ⑦ Bảo mật | IAM phân quyền, VPC cô lập mạng |
Tôi có thể vẽ sơ đồ kiến trúc tổng thể này để dễ hình dung hơn nếu bạn cần.
All rights reserved
